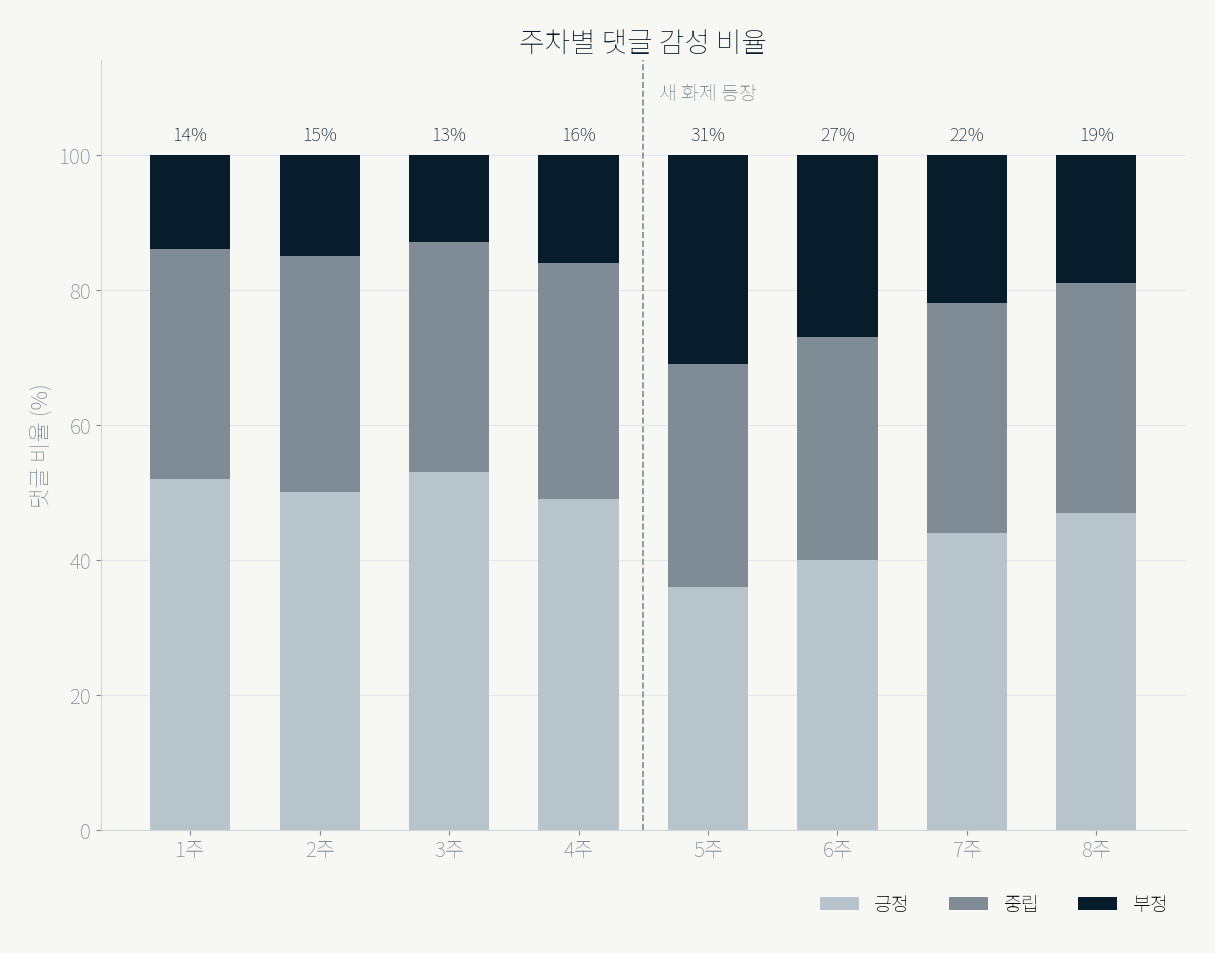
설문의 주관식 응답, 민원 기록, 상담 일지처럼 글로 쌓인 자료를 받으면 먼저 단어 빈도표와 워드클라우드를 요청받습니다. 빈도표는 어떤 말이 많이 나왔는지는 알려 주지만 그 말이 어떤 맥락에서 쓰였는지는 알려 주지 않습니다. 저희가 텍스트마이닝을 맡을 때 정하는 순서를 적습니다.
1. 분석 단위
응답 한 건을 한 문서로 볼지, 문장 단위로 나눌지를 먼저 정합니다. 한 응답에 불만과 제안이 함께 들어 있으면 문서 단위 분석은 둘을 섞습니다. 짧은 응답이 대부분이면 문장 단위는 잡음을 키웁니다. 자료를 백 건쯤 읽어 보고 단위를 정하면 뒤의 재작업이 줄어듭니다.
2. 사전
형태소 분석기는 기관 이름, 제도 명칭, 현장에서 쓰는 줄임말을 제대로 자르지 못합니다. 사용자 사전에 고유 명사를 등록하고, 같은 뜻의 표현을 하나로 묶는 동의어 사전과 분석에서 뺄 불용어 목록을 만듭니다. 세 가지 사전은 보고서 부록에 싣습니다. 사전이 없으면 같은 자료를 다시 분석해도 결과가 달라집니다.
3. 주제 수
토픽 모형에서 주제 수를 정할 때 일관성 지표 같은 통계만 보면 주제가 지나치게 잘게 나뉘거나 뭉칩니다. 지표가 비슷한 후보를 몇 개 두고, 각 주제의 대표 문서를 사람이 읽어 이름을 붙일 수 있는지로 정합니다. 이름을 붙이기 어려운 주제는 합치거나 뺍니다.
4. 동시출현 네트워크
어떤 단어가 어떤 단어와 함께 나오는지를 그리면 빈도표에서 보이지 않던 묶음이 드러납니다. 선이 많아질수록 그림은 읽기 어려워지므로 중심성이 높은 단어 몇 개와 그 주변만 남기고, 그 묶음이 자료에서 실제로 어떤 문장으로 나타나는지 원문을 함께 보여 줍니다.
5. 해석
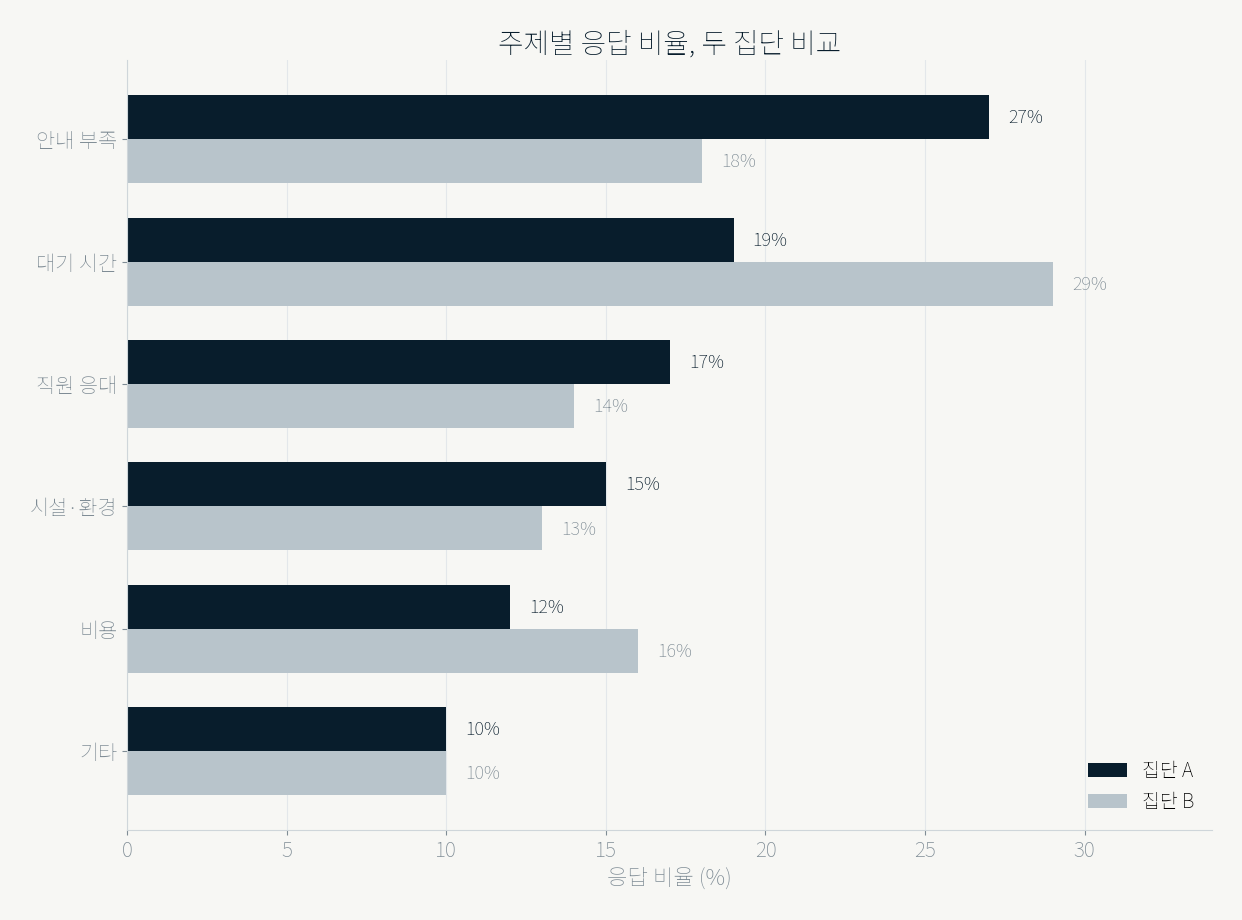
주제별 비율, 집단별 차이, 기간별 변화를 쓸 때마다 그 수치를 대표하는 원문을 두세 건 인용합니다. 원문이 있어야 분석자가 아닌 사람도 결과를 설명할 수 있습니다.
결과물로 받아야 할 것
워드클라우드 외에 분석 단위와 전처리 기준, 사용자 사전과 불용어 목록, 주제 수를 정한 근거, 주제별 대표 원문, 집단이나 기간에 따른 비교표를 함께 받으십시오.